
Kurumsal yapay zekanın özünde sessiz bir ironi yatıyor: Dünyanın en akıllı modelleri bile verileriniz taranmış bir faturada, faksla gönderilmiş bir laboratuvar raporunda veya el yazısıyla yazılmış bir teslimat notunda sıkışıp kalmışsa size yardımcı olamaz. Ve işletme verilerinin tahmini %80'i tam olarak bu tür yapılandırılmamış belgelerde yer alıyor.
Optik Karakter Tanıma (OCR), verileri özgürleştiren teknolojidir. Ve 2026'da, bu teknoloji büyük bir ivme kazanıyor. Küresel OCR pazarının 2023'teki 13.1 milyar dolardan 2033'te 55.3 milyar dolara ulaşması ve yılda %15.5 oranında büyümesi bekleniyor. Modern motorlar, sayfa düzeyinde %98-99 doğruluk oranına rutin olarak ulaşıyor. Bir zamanlar hantal bir tarama aracı olan bu teknoloji, kurumsal otomasyonun ön kapısı haline geldi.
İşte günümüzdeki OCR teknolojisinin görünümü: nasıl çalıştığı, mevcut türleri, yapay zekanın getirdiği değişiklikler ve geleceği.
OCR nedir?
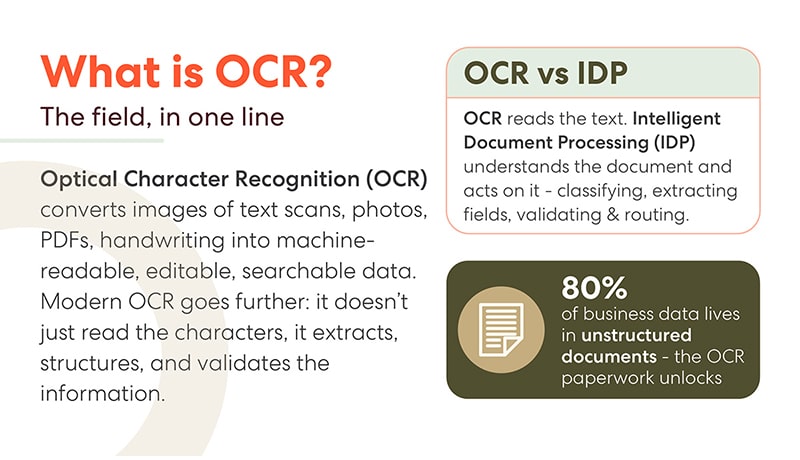
Optik Karakter Tanıma (OCR), metin görüntülerini (tarama, fotoğraf, PDF, el yazısı) makine tarafından okunabilir, düzenlenebilir ve aranabilir verilere dönüştürür. Bu, ders kitaplarındaki tanımdır ve 2026'da gerçekte olanları hafife almaktadır.
Modern OCR yalnızca karakterleri okumakla kalmaz. Alanlar, tablolar, satır öğeleri gibi yapıları çıkarır ve çektiği bilgileri doğrular. Telefonla çekilmiş buruşuk bir faturayı ona verin, metin yığını değil, yapılandırılmış bir kayıt döndürür: satıcı, tarih, satır öğeleri, toplam, her biri bir güven puanıyla birlikte.
OCR ve IDP Arasındaki Önemli Ayrım
Bu iki terimi de her satıcı görüşmesinde duyacaksınız, işte aralarındaki fark: OCR metni okur. Akıllı Belge İşleme (IDP) ise belgeyi anlar ve ona göre hareket eder ; belgenin türünü sınıflandırır, önemli alanları çıkarır, iş kurallarına göre doğrular ve sonucu doğru sisteme yönlendirir.
OCR'ı gözler, IDP'yi ise beyin olarak düşünün. Biri olmadan diğeri sizi ancak yarı yolda bırakır: mükemmel şekilde yazıya dökülmüş metin yine de insan yorumuna ihtiyaç duyar veya okunabilir girdiden yoksun akıllı bir iş akışı. Piyasa kesin olarak bu kombinasyona doğru ilerliyor.
OCR Nasıl Çalışır: Modern 6 Adımlı İşlem Hattı
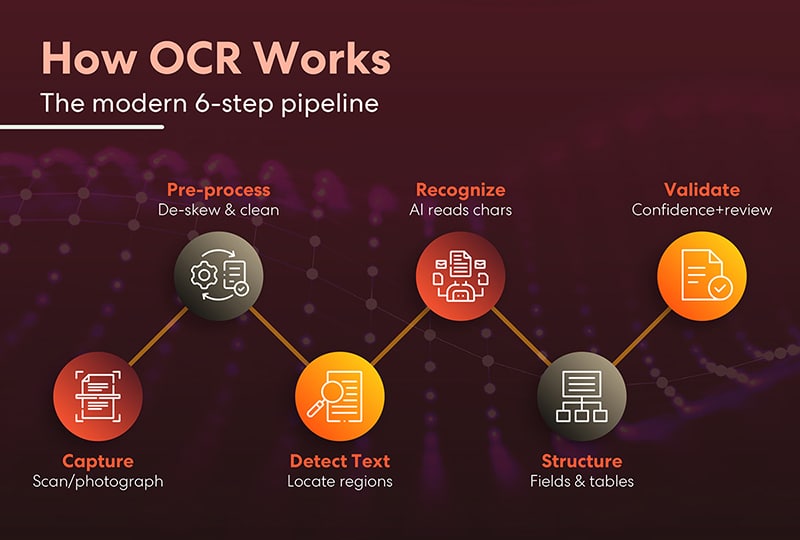
Günümüzün optik karakter tanıma (OCR) sistemleri altı aşamalı bir süreç izler ve bunu anlamak, doğruluğun neden bu kadar arttığını ve hataların hala nereden kaynaklandığını açıklamaya yardımcı olur.
İşlem , belgenin taranması veya fotoğraflanmasıyla başlar . Ardından ön işleme, görüntüyü temizler: eğik sayfaları düzeltir, gürültüyü giderir ve kontrastı düzeltir, çünkü tanıma kalitesi ancak başlangıçtaki görüntü kadar iyidir. Daha sonra, metin tespiti, sayfada gerçekten metin içeren bölgeleri bulur ve kelimeleri logolardan, damgalardan ve arka plandan ayırır. Ardından, yapay zekanın karakterleri okuduğu tanıma gelir ; çoğu insanın "OCR" olarak düşündüğü adım budur. Ancak modern süreç burada bitmez. Yapılandırma, ham metni alanlara ve tablolara eşler, "sayfadaki kelimeleri" "şemadaki verilere" dönüştürür. Son olarak, doğrulama , güven puanlaması ve incelemesi uygular ve sistemlerinize girmeden önce insan için belirsiz olan her şeyi işaretler.
Yakalama → ön işleme → algılama → tanıma → yapılandırma → doğrulama. Son iki adım, 2026 dönemi OCR'yi on yıl önceki tarama yazılımlarından ayıran unsurlardır.
OCR Türleri: Tüm Tanıma İşlemleri Aynı Değildir
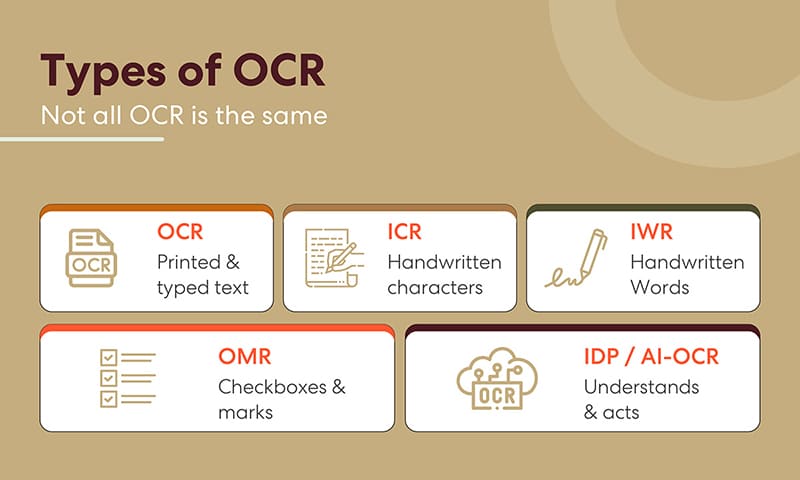
"OCR" genel bir terim olarak kullanılsa da, bu alan farklı içeriklere uygun çeşitli teknolojileri birbirinden ayırmaktadır.
OCR, basılı ve daktilo edilmiş metinleri işler; bu en kolay ve en olgun teknolojidir. ICR (Akıllı Karakter Tanıma), el yazısı karakterleri okur; bu, alanın en zor problemlerinden biridir. IWR (Akıllı Kelime Tanıma) bir adım daha ileri giderek, tek tek harfler yerine tüm el yazısı kelimeleri tanır; karakterlerin birbirine karıştığı el yazısı için daha uygundur. OMR (Optik İşaret Tanıma), onay kutularını ve işaretleri okur; bu teknoloji formların ve cevap kağıtlarının arkasındaki teknolojidir. Ve IDP / AI-OCR, en üstte yer alır: sadece okumakla kalmayıp anlayan ve harekete geçen sistemler.
Herhangi bir OCR projesinin ilk sorusu, belgelerinizin hangi türe ihtiyaç duyduğunu bilmektir. Basılı bir fatura ve doktorun el yazısıyla yazdığı bir reçete tamamen farklı sorunlardır.
Yapay Zeka Çağında OCR: Ham OCR Artık Sadece İlk Adım
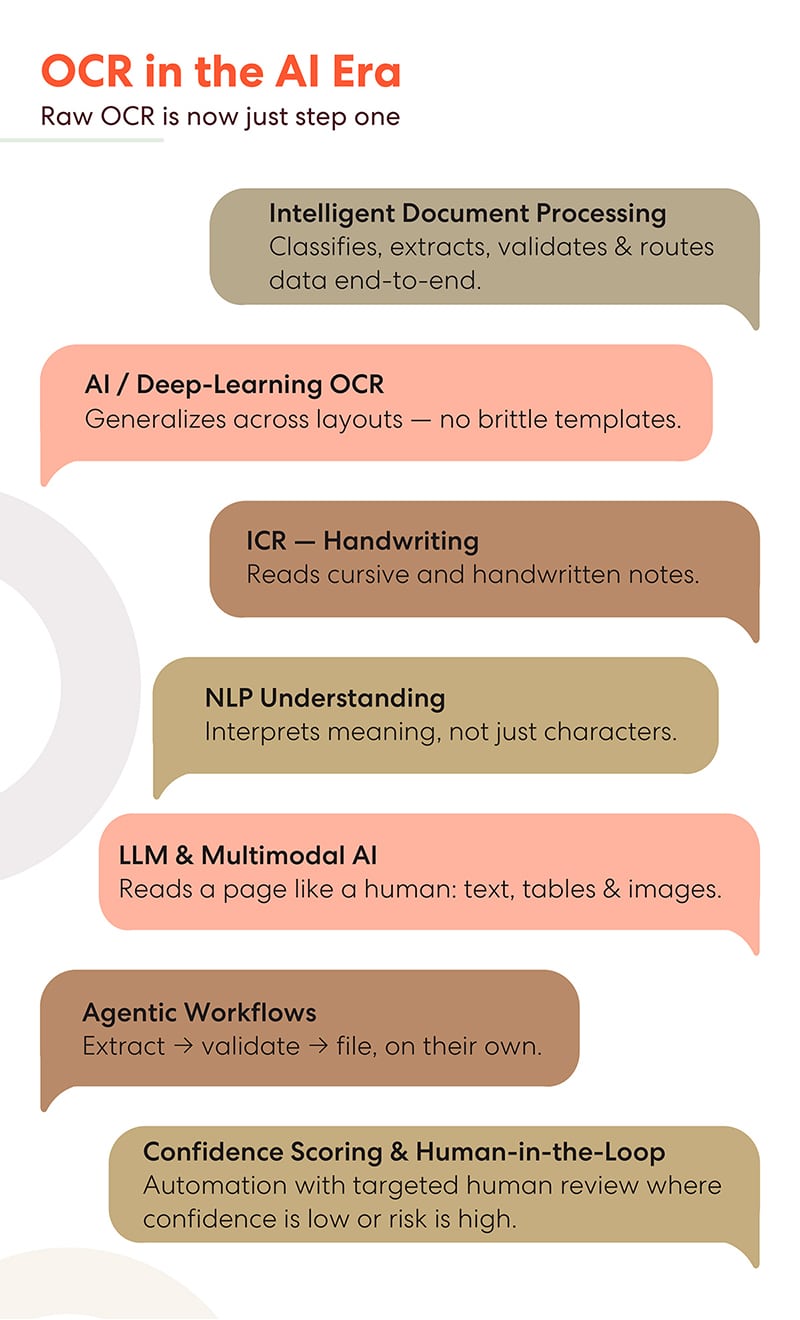
Bu alandaki en köklü değişiklik, bir zamanlar ürünün tamamını oluşturan karakter tanıma özelliğinin artık sadece giriş noktası olmasıdır. Modern belge yapay zekasını tanımlayan yedi yetenek vardır.
Akıllı Belge İşleme , belgeleri sınıflandırma, alanları ayıklama, verileri doğrulama ve sonuçları manuel aktarıma gerek kalmadan yönlendirme dahil olmak üzere tüm süreci baştan sona yönetir.
Yapay zeka ve derin öğrenme tabanlı optik karakter tanıma (OCR), farklı düzenlerde genelleme yapabiliyor. Eski sistemler her belge formatı için kırılgan bir şablona ihtiyaç duyarken, modern modeller daha önce hiç görmedikleri bir faturayı bile işleyebiliyor çünkü faturaların genel olarak nasıl göründüğünü öğrenmiş durumdalar.
ICR el yazısı tanıma teknolojisi, bitişik el yazısı ve el yazısı notları okuyabilecek seviyeye ulaştı; böylece daha önce erişilemeyen tıbbi kayıtlar, teslimat fişleri ve arşiv belgelerinin kilidini açtı.
NLP, yalnızca karakterleri değil, anlamı da yorumlar. Sistem sadece "Net 30" ifadesini yazıya dökmekle kalmaz, bunun bir ödeme koşulu olduğunu da bilir.
LLM'ler ve çok modlu yapay zeka, bir sayfayı tıpkı bir insan gibi okur: metni, tabloları ve görselleri birlikte, bağlam içinde. Bu, teknoloji yığınının en yeni ve en hızlı gelişen katmanıdır.
Aracı tabanlı iş akışları döngüyü tamamlar: ayıklama → doğrulama → dosyalama, tamamen otonom olarak. Belge sadece okunmaz; aynı zamanda işlenir.
İnsan müdahalesi içeren güven puanlaması, tüm bunların güvenli bir şekilde uygulanmasını sağlar. Otomasyon, güvenin yüksek olduğu durumlarda ilerler; insanlar yalnızca güvenin düşük olduğu veya riskin yüksek olduğu durumlarda inceleme yapar. Bu hedefli inceleme modeli, işletmelerin hem hız hem de denetlenebilirlik elde etmesini sağlar.
OCR Kullanım Alanları: Değer Kattığı Noktalar
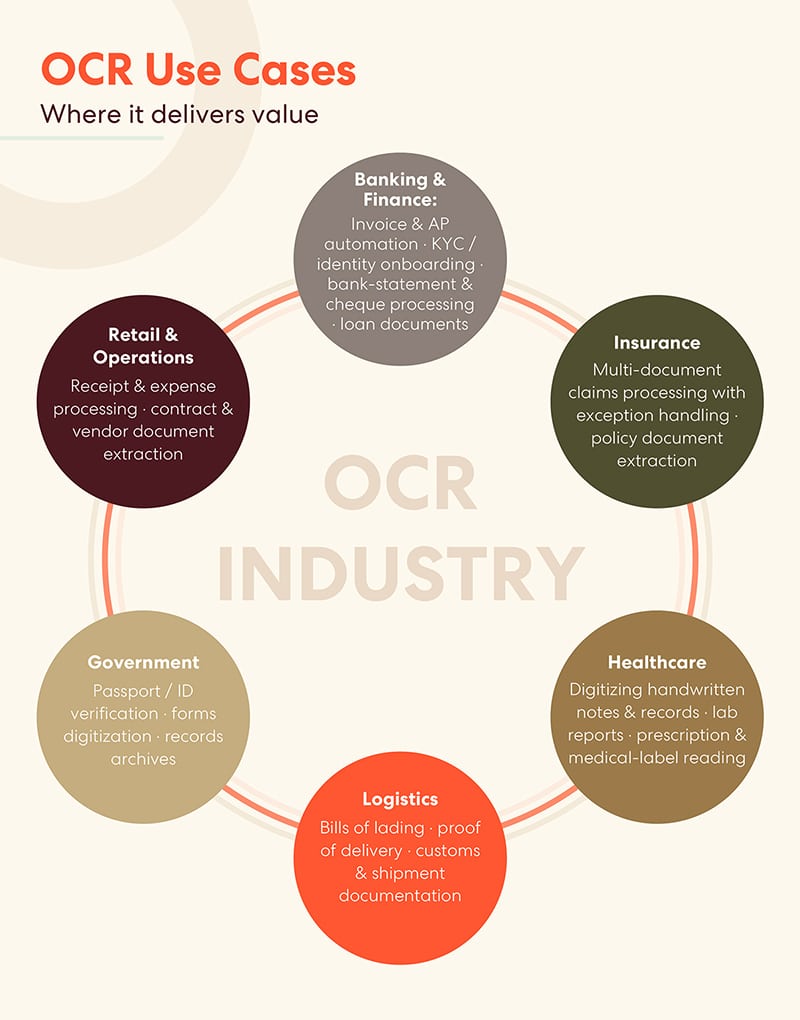
OCR teknolojisini en hızlı benimseyen sektörler, kağıt yığınları içinde boğulan sektörlerdir.
Bankacılık ve finans sektörü pazara öncülük ediyor: fatura ve ödeme otomasyonu, KYC ve kimlik doğrulama, banka ekstresi ve çek işleme. BFSI'nin yaklaşık %21'lik pazar payıyla en büyük OCR dikey alanı olması tesadüf değil. Sigorta sektörü, istisna yönetimi ve poliçe belgesi çıkarma ile çoklu belge taleplerinin işlenmesinde OCR kullanıyor; tek bir talep, farklı formatlarda düzinelerce belge içerebilir. Sağlık sektöründe OCR, el yazısı notları ve kayıtları dijitalleştiriyor, laboratuvar raporlarını okuyor ve reçeteleri ve tıbbi etiketleri işliyor; burada doğruluk kelimenin tam anlamıyla bir güvenlik sorunu. Lojistik, belgelere dayanıyor: konşimento, teslimat kanıtı, gümrük ve sevkiyat evrakları; ve OCR, evrak işlerinin darboğaz olmasını engelleyerek malların hareketini sağlıyor. Devlet, pasaport ve kimlik doğrulama, form işleme ve kayıt arşivlerinin dijitalleştirilmesinde OCR kullanıyor. Perakende ve operasyonlarda ise makbuz ve gider işleme ile sözleşme ve tedarikçi belgesi çıkarma işlemlerini destekliyor.
Altı grubun tamamında ortak nokta şu: Eskiden bir insan kağıttan sisteme bilgi yazarken, şimdi bunu OCR daha hızlı, daha ucuz ve denetim iziyle yapıyor.
Faydaları ve Zorlukları: Dürüst Bir Bakış
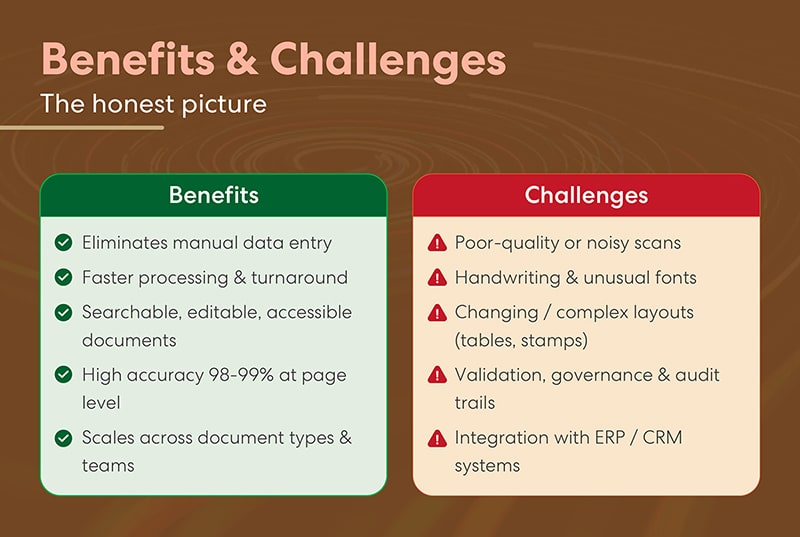
Faydaları somut. OCR, herhangi bir arka ofiste en çok hataya yol açan ve en sevilmeyen iş olan manuel veri girişini ortadan kaldırır. İşlem ve geri dönüş süreleri önemli ölçüde hızlanır. Belgeler, ölü taramalar yerine aranabilir, düzenlenebilir ve erişilebilir hale gelir. Doğruluk artık sayfa düzeyinde %98-99'a ulaşıyor. Ve modern sistemler, bilinmeyen herhangi bir şeyde takılmak yerine, belge türleri ve formatları arasında ölçeklenebilir.
Ancak gerçek uygulamalar hala gerçek sorunlarla karşılaşıyor. Kalitesiz veya gürültülü taramalar, doğruluğu en çok düşüren faktör olmaya devam ediyor; hiçbir model okunaksız olanı okuyamaz. El yazısı ve alışılmadık yazı tipleri, basılı metni hala takip ediyor. Değişen ve karmaşık düzenler (iç içe tablolar, damgalar, çok sütunlu formlar) veri çıkarmayı zorlaştırıyor. Doğrulama, yönetişim ve denetim izleri, özellikle düzenlemeye tabi sektörlerde, gerçek mühendislik çabası gerektiriyor. Ve ERP ve CRM sistemleriyle entegrasyon, birçok projenin takıldığı nokta: Veri çıkarma, ancak verilerin gerçekten işin yapıldığı yere ulaşması durumunda faydalı oluyor.
Bunların hiçbiri anlaşmayı bozacak nitelikte değil. Güvenirlik puanlamasının ve insan müdahalesiyle yapılan incelemenin var olma sebebi bunlar; ayrıca belge kalitesinin ve iyi etiketlenmiş eğitim verilerinin model seçimi kadar önemli olmasının sebebi de bu.
OCR Pazarı: Kaynak ve Güncel Durum
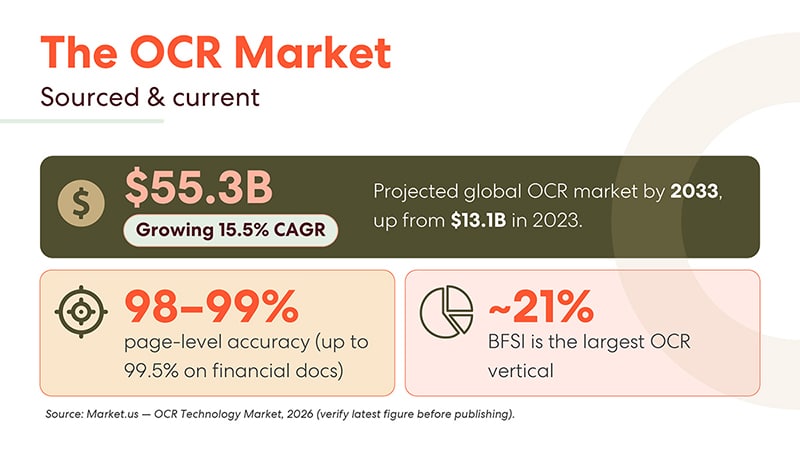
Rakamlar fırsatı ortaya koyuyor. Küresel OCR pazarının 2023'teki 13.1 milyar dolardan 2033'te 55.3 milyar dolara ulaşması bekleniyor; bu da %15.5'lik bir bileşik yıllık büyüme oranı anlamına geliyor . Sayfa düzeyinde doğruluk %98-99'a ulaşmış durumda ve finansal belgelerde bu oran daha da yükseliyor. Bankacılık, finansal hizmetler ve sigorta sektörü (BFSI) ise pazarın yaklaşık %21'ini oluşturarak en büyük dikey sektör konumunda ve bu da yatırım getirisinin (ROI) ilk olarak nerede kanıtlandığının bir göstergesi.
Gelecek Ne Getiriyor: 2026 İçin OCR Trendleri
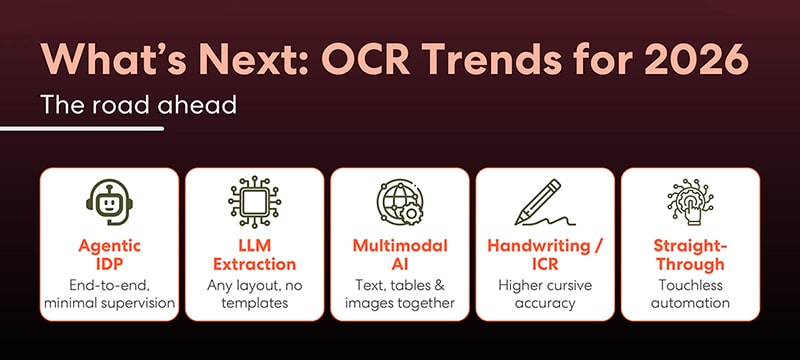
Önümüzdeki yolu beş trend belirliyor. Otonom IDP (İnternet Veri İşleme) — sorunsuz bir şekilde, uçtan uca çalışan belge iş akışları. LLM (Dil Modellemesi) destekli veri çıkarma — büyük dil modellerini kullanarak, az veya hiç şablon kurulumu gerektirmeden belgelerden yapılandırılmış veri çekme. Çok modlu yapay zeka — metin, tablo ve görüntüleri tek geçişte işleyen, belgeleri parçalar halinde değil, bir bütün olarak anlayan modeller. El yazısı ve ICR (Bilgisel Tanıma) alanındaki gelişmeler — el yazısı ve düzensiz el yazısında sürekli artan doğruluk, daha önce yalnızca manuel olarak işlenen belge sınıflarını mümkün kılıyor. Ve uçtan uca işleme — nihai hedef: sıfır insan müdahalesiyle gelen, okunan, doğrulanan ve dosyalanan belgeler.
Yönelim gayet açık: belgeleri okumaktan, onları işlemeye doğru.
Alt çizgi
2026'da OCR artık sadece resimleri metne dönüştürmekle ilgili değil; evrakları tamamlanmış işlere dönüştürmekle ilgili. İş verilerinin %80'i yapılandırılmamış belgelerde kilitliyken ve pazar 55 milyar dolara doğru yükselirken, çoğu kuruluş için soru OCR'ı benimseyip benimsememek değil, hangi aşamaya kadar gidileceği: düz metin çıkarma, yapılandırılmış belge işleme (IDP) veya tamamen ajans tabanlı belge iş akışları.
Belgeler zaten birikmeye başladı. Bunları okumak ve bunlara göre hareket etmek için gereken teknoloji de hazır.