Poz tahmini, vücut kilit noktalarını (eklemler ve yüz hatları) bulup bunları bir kişinin veya nesnenin nasıl konumlandığını ve hareket ettiğini açıklayan bir iskelete bağlayan bilgisayar görüşü görevidir. Fiziksel yapay zeka için, bu iskelet hareket verileri, gözlemlenen insan hareketini bir robotun taklit edebileceği ve uygulayabileceği eylemlere dönüştüren köprüdür.
İşte sektörün dikkatini sessizce kaydıran son cümle bu. On yıl boyunca, poz tahmini fitness uygulamalarında ve spor yayınlarında yer aldı - kullanışlıydı, ancak sınırlıydı. Şimdi aynı kilit noktalar ve iskeletler, insansı robotların, otonom sistemlerin ve görme-dil-eylem modellerinin arkasındaki temel eğitim sinyali haline geldi. Bir robot bir şeyi dökmeyi, istiflemeyi, sıralamayı veya bir kişiye vermeyi öğrendiğinde, öğrendiklerinin çoğu önce insanların bunu nasıl yaptığını izlemekten gelir - ve bu izleme poz verisidir.
Poz Tahmini Gerçekte Neyi Yakalıyor?
Özünde, poz tahmini bir dizi kilit noktayı (omuzlar, dirsekler, bilekler, kalçalar, dizler ve ayak bilekleri gibi anatomik işaret noktaları ve gözler, burun ve kulaklar gibi yüz noktaları) tespit eder ve bunları duruşu ve hareketi temsil eden bir iskelete bağlar . Bu iskeleti kareler boyunca takip ederek, bir vücudun zaman içinde nasıl hareket ettiğine dair kompakt, makine tarafından okunabilir bir açıklama elde edersiniz.
Bu alan birkaç bilindik çizgi boyunca ayrılıyor. İnsan poz tahmini insanlara odaklanırken, aynı teknikler hayvanlar ve nesneler için de geçerli. Algılama 2 boyutlu (anahtar noktaları x, y piksel koordinatları olarak belirleme) veya 3 boyutlu (gerçek bir uzamsal iskelet için derinlik, z ekleme) olabilir. Daha fazla model katmanı seçeneği de var – örneğin tek kişi veya çoklu kişi algılama – ancak bunlar model ekibinin mimari kararlarıdır, eğitim verilerinin özellikleri değildir. Bir poz modelinin başarılı olup olmadığını belirleyen şey algılama stratejisi değil; öğrendiği anahtar noktaların doğruluğu, tutarlılığı ve kapsamıdır. Bu bir veri problemidir ve ekiplerin hafife aldığı kısımdır.
Fiziksel Yapay Zeka İçin Poz Verilerinin Eksik Bağlantı Noktası Olmasının Nedenleri
Fiziksel bir yapay zeka sistemi, bir sohbet robotunun asla yapmadığı bir döngüyü tamamlamak zorundadır: dünyayı algılamak, karar vermek ve ardından fiziksel olarak harekete geçmek . Algılama olgunlaştı; robotlar görebiliyor. Zor olan kısım, gördüklerini koordineli, fiziksel olarak doğru bir eyleme dönüştürmektir ve bunu sağlayan şey de duruş ve hareket verileridir.
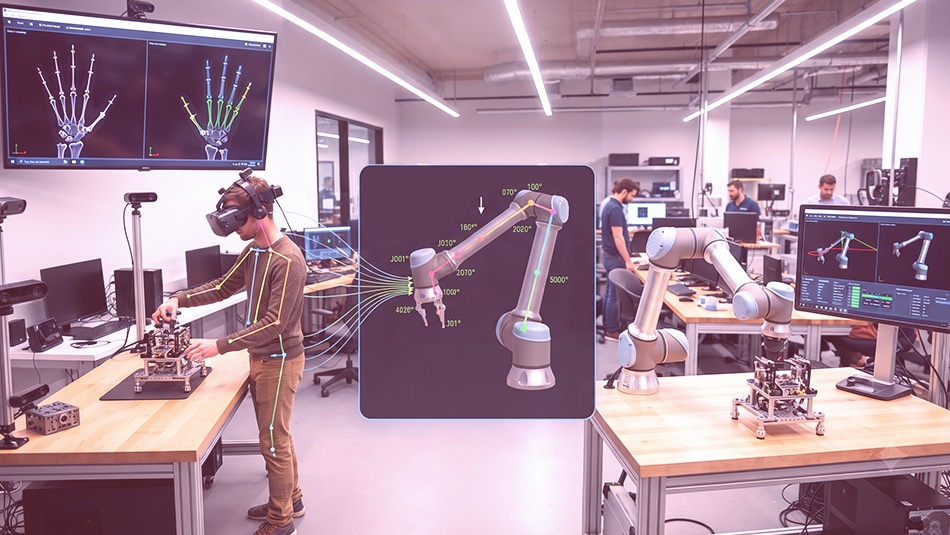
Modern robot öğrenme süreçlerinin becerileri nasıl edindiğini düşünün. Uzaktan kumanda yoluyla kaydedilen gerçek robot gösterileri hassas ancak toplanması yavaş ve maliyetlidir. Bu nedenle ekipler giderek daha bol miktarda bulunan bir şey üzerinde ön eğitim yapıyor: görevleri yerine getiren insanların videoları. Son robotik araştırmaları, büyük ölçekli, benmerkezci insan videoları üzerinde önceden eğitilmiş politikaların, yalnızca robot verileri üzerinde eğitilmiş politikalardan daha iyi genelleme yapabildiğini göstermiştir; çünkü insan videoları, laboratuvarda toplanan robot verilerinin büyük ölçekte eşleşemediği çeşitliliği, fiziği ve görev yapısını taşır.
Ancak ham insan videosu bir robot tarafından doğrudan kullanılamaz. Bir robotun vücudu sizinle aynı değildir; kendine özgü eklemleri, uç efektörleri ve serbestlik dereceleri vardır. Duruş tahmini, çeviri katmanıdır. Bir insan gösterisini yapılandırılmış bir iskelete -ve kritik olarak bir el iskeletine- indirgeyerek, bu hareket bir robotun kinematiğine yeniden yönlendirilebilir ve bir politikanın üzerinde eğitilebileceği eylem yörüngelerine dönüştürülebilir. Bu, tam olarak görme-dil-eylem (VLA) modellerinin ihtiyaç duyduğu girdidir .
Poz verileri, fiziksel-yapay zeka yığınında üç tekrar eden biçimde ortaya çıkar: uzaktan kumanda sırasında yakalanan operatör pozu , insanlarla güvenli bir şekilde alanı paylaşması gereken işbirlikçi robotlar için işçi pozu ve birinci şahıs egosantrik videodan elde edilen ve robot eylemine yeniden hedeflenen insan gösterim pozu . Her durumda, iskeletin kalitesi, robotun öğrenebileceği hareket kalitesinin üst sınırını belirler.
Hareket Yakalamadan Robot Hareketine
İnsan hareketinden robot hareketine giden köprü, genellikle tam bir vücudu (ve elleri) tahmini kilit noktalara uyduran ve sıradan videodan fiziksel olarak tutarlı hareket üreten parametrik 3D vücut modelleme tekniklerinden geçer. Bu, aslında işaretleyici gerektirmeyen hareket yakalama yöntemidir. Robotik için, uydurulan vücut, temiz eylem yörüngelerinin kaynağı haline gelir: uzanma, kavrama, kaldırma, yerleştirme, bırakma; her aşama bölümlere ayrılır ve zamanlanır. Altta yatan pozisyon açıklaması ne kadar iyi olursa, yeniden hedeflenen yörünge de o kadar temiz olur.
2D mi, 3D mi Pozlama? Robotunuz Hangisine Gerçekten İhtiyaç Duyuyor?
Robotik takımlarının en sık sorduğu soru budur ve dürüst cevap şudur: robotun bu pozla ne ilgisi olduğuna bağlıdır .
2 boyutlu poz tahmini, görüntü düzleminde anahtar noktalar verir. Şekil kontrolü, jest tanıma ve aktivite sınıflandırması için yeterlidir ve yakalaması daha ucuz, etiketlemesi daha hızlıdır. Ancak elin kupadan ne kadar uzakta olduğunu veya bir eklemin uzaydaki gerçek açısını size söyleyemez.
3D poz tahmini , derinlik eksenini ekleyerek üç boyutlu olarak konumlandırılmış metrik bir iskelet oluşturur. Kavrama, yerleştirme, temasın yoğun olduğu görevler gibi manipülasyon işlemleri için bu genellikle vazgeçilmezdir, çünkü bir robotun bir şeye dokunması gerektiği anda kavrama noktaları ve eklem açıları metrik doğruluk gerektirir. Üç boyutlu poz genellikle stereo veya derinlik kameraları, LiDAR, çoklu kamera sistemleri veya 2D'den 3D'ye dönüştürme ile elde edilir ve hem yakalama hem de açıklama açısından daha maliyetlidir.
Müşterilerimize verdiğimiz kural şudur: Sisteminizin yalnızca hareketi anlaması gerekiyorsa , 2D yeterli olabilir; ancak fiziksel dünyadaki hareketi yeniden üretmesi gerekiyorsa , 3D'yi planlayın ve sensör yığınınızı ve açıklama şemanızı ilk günden itibaren buna göre tasarlayın, ilk başarısız denemeden sonra değil.
El Duruşu ve Becerisi
Robotun vücut pozisyonu nesneye ulaşmasını sağlarken, el pozisyonu da oraya ulaştıktan sonra başarılı olmasını sağlar. Becerikli manipülasyon, parmak eklemlerinin, temas noktalarının ve kavrama konfigürasyonunun ince ayrıntılı takibine bağlıdır; genellikle el başına yirmi veya daha fazla kilit nokta. Fiziksel yapay zekanın büyük bir kısmı şu anda burada darboğaz yaşıyor ve açıklama standardı en yüksek seviyede. Eşleştirilmiş video ve el pozisyonu verileri, manipülasyon öğretiminde güçlü olduğunu kanıtlamıştır; ancak bunu güvenilir bir şekilde ve yüksek hacimde üretmek özel bir disiplindir.
Poz Verilerinin Bozulduğu Yer
Poz modelleri tahmin edilebilir şekillerde başarısız olur ve bunların neredeyse tamamı mimariden ziyade eğitim verilerine dayanır:
- Tıkanma Uzuvlar gövdelerin arkasına gizlenir, eller nesnelerin arkasında kaybolur, özneler kadrajdan çıkar. Gizli kilit noktaları dürüstçe işaretlemeniz veya tahmin etmeniz, modelin güvenilirliğini şekillendirir.
- Birden fazla kişinin örtüşmesi. Bedenler kesiştiğinde, kilit noktalar yer değiştirir veya birleşir; bu nedenle disiplinli kimlik takibi önemlidir.
- Bakış açısı, ışıklandırma ve kıyafet farklılıkları. Sadece temiz, önden çekilmiş ve iyi aydınlatılmış kareler üzerinde eğitilmiş bir model gerçek dünyada çöker.
- Derinlik belirsizliği. 3 boyutlu pozisyonlarda, sınırlı görüş açılarından derinlik çıkarımı yapmak doğası gereği zordur ve yanlış geometri öğretimini önlemek için tutarlı açıklamalar gerektirir.
- Dinamik hareket. Hızlı hareket bulanıklığa ve kareler arası kaymaya neden olur; kilit noktaların yalnızca tek karelerde doğru olması değil, zaman içinde de sabit kalması gerekir.
- Anatomik tutarlılık. Bir karede bilekten, diğer karede ise önkolun ortasından işaretlenen bir bilek, veri setini sessizce zehirliyor.
Özetle: bir poz modeli, temel noktalarındaki her tutarsızlığı miras alır ve fiziksel yapay zekada bu tutarsızlıklar yanlış – bazen de güvensiz – hareketlere dönüşür. Veri hacmi kadar, veri etiketleme sürecinin disiplini de önemlidir.
Gerçekçi Bir Poz Oluşturma Sürecinin İç Yüzü: Shaip'in 150,000 Karelik Anahtar Nokta Projesi
Bir bilgisayar görüşü müşterisi için Shaip, hem poz tahmini hem de yüz hareketi analizini tek bir geçişte desteklemek üzere oluşturulmuş, özel bir 36 anahtar nokta şemasına (yüzdeki önemli noktalar ve tam vücut iskeleti) karşı 150,000 kare görüntü ve video üzerinde işaretleme yaptı . Çalışma, çeşitli pozları, açıları, aydınlatmayı ve kıyafetleri kapsadı; örtüşme dürüst bir şekilde ele alındı (gizli noktalar işaretlendi, asla tahmin edilmedi) ve her kare, kalibre edilmiş bir doğruluk ölçütüne göre yapılandırılmış kalite kontrolünden geçti. Sonuç, müşterinin poz, hareket, fitness ve sağlık-hareket modellerinin arkasındaki üretime hazır bir iş akışı oldu. Tüm ayrıntılar, insan vücudu anahtar nokta işaretleme vaka çalışmamızda yer almaktadır.
Özetle: Bu proje insan hareketini modelleyen bir projeydi, ancak gerektirdiği disiplin – yoğun özel bir şema, dürüst örtüşme yönetimi ve büyük ölçekte poz çeşitliliği – insansı robot veya işbirlikçi robot politikalarının gerektirdiği disiplinle aynıdır. Uygulama değişir; veri standardı değişmez.
Poz Tahmini Kullanım Alanları: Gerçek Dünya Uygulamaları
Poz ve hareket verileri artık robotik alanının çok ötesinde sistemleri eğitiyor ve her alan kendi kilit nokta şemasını ve doğruluk standardını belirliyor. Fiziksel yapay zeka ekipleri için faydalı olan nokta, bunların aynı varlığın örtüşen kaynakları olduğudur: yüksek doğrulukta insan hareket verileri, somutlaştırılmış zekaya yönlendirilebilir.
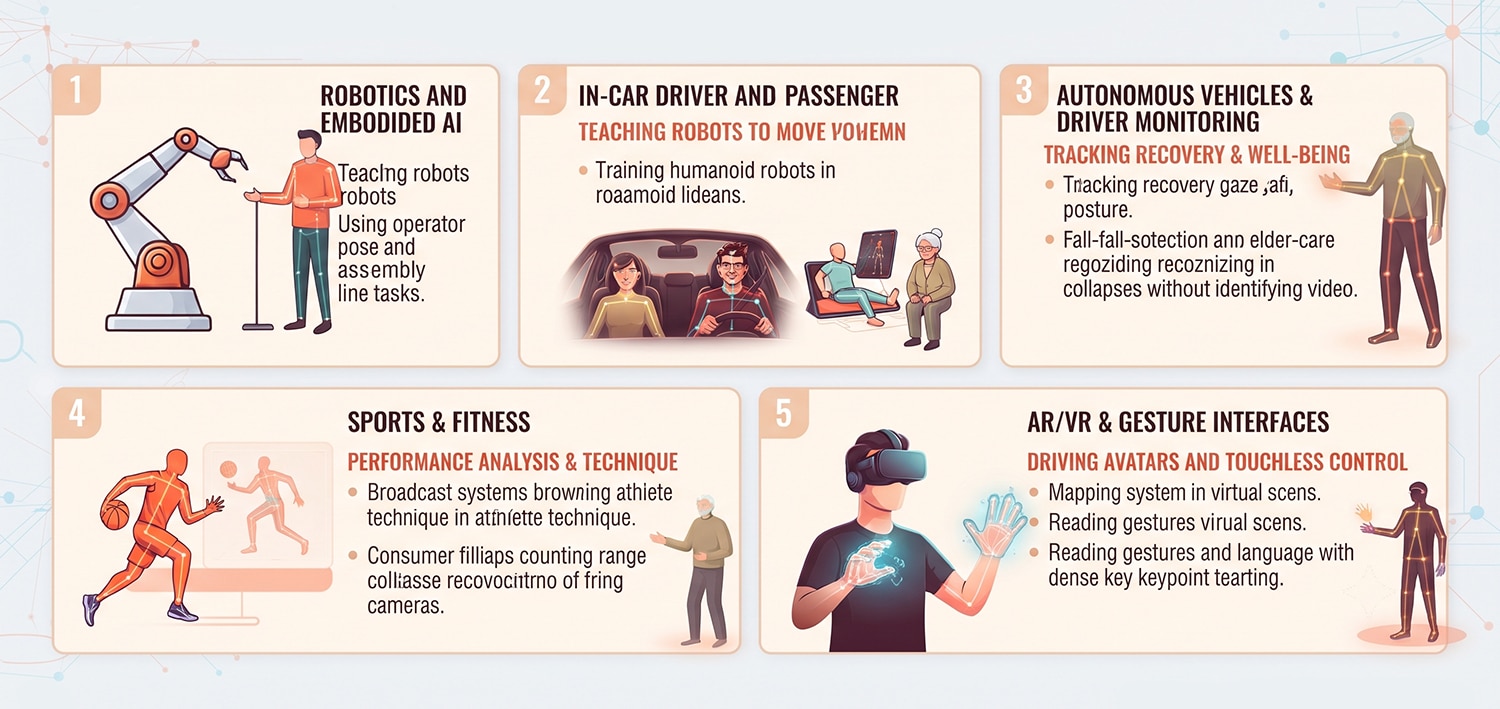
Robotik ve somutlaştırılmış yapay zeka – en önemli sınır. Duruş verileri, robotlara insan gösteriminden öğrenerek hareket etmeyi öğretiyor. Depoda çalışan insansı bir robot, taşıma kolilerini kaldırmayı ve konveyöre yerleştirmeyi öğrenirken, kısmen aynı görevi yapan insanların duruş izlemeli videolarından eğitim alıyor; uzaktan kumanda oturumlarından elde edilen operatör duruşu ise hassas hareket yörüngelerini sağlıyor. Montaj hatlarında, işbirlikçi robotlar, gerçek zamanlı işçi duruşunu kullanarak güvenli bir mesafeyi koruyor ve çarpışma olmadan parçaları teslim ediyor – bu tür taşıma ve hat kenarı görevleri şu anda lojistik ve otomotiv fabrikalarında pilot uygulamalarla test ediliyor.
Otonom araçlar ve sürücü izleme. Kabin içinde, duruş tahmini sürücünün baş pozisyonunu, bakışını ve üst vücut duruşunu izleyerek uykululuk veya dikkat dağınıklığını tespit eder. Euro NCAP'in 2026 güvenlik derecelendirme gereksinimlerini karşılamak için yeni araçlarda bulunan sürücü izleme sistemleri, tam olarak bu yüz işaret noktalarına ve kilit nokta verilerine bağlıdır.
Sağlık ve rehabilitasyon. Duruş tahmini, bir vücudun gerçekte nasıl hareket ettiğini ölçer ve klinisyenler bunu iyileşmeyi takip etmek için kullanır. Bir fizyoterapi uygulaması, hastanın egzersizini telefon kamerası aracılığıyla izleyebilir, hareket aralığını sayabilir ve yanlış duruşu işaretleyebilir; yaşlı bakım ortamındaki bir düşme algılama sistemi, tanımlayıcı video kaydetmeden, yalnızca iskelet hareketinden bir çökmeyi tanıyabilir.
Spor ve fitness. İskelet takibi, sıradan videoları performans verilerine dönüştürüyor. Yayın sistemleri, tekniği analiz etmek için sporcuların gerçek zamanlı iskeletlerini üst üste bindirirken, tüketici fitness uygulamaları yalnızca bir telefon kamerası kullanarak tekrarları sayıyor ve doğru formu düzeltiyor.
AR/VR ve jest arayüzleri. Vücut ve el pozisyonu avatarları yönlendirir ve dokunmadan kontrol imkanı sağlar. Ellerinizi sanal bir sahneye eşleyen bir kulaklık veya jestleri ve işaret dilini okuyan bir arayüz, yoğun el-anahtar nokta takibine ve ağır kendi kendini örtme durumuna dayanır.
Poz ve Anahtar Nokta Veri Ortağı Seçimi
Poz verisi oluşturma işini kimin yapması gerektiğine karar veriyorsanız, tedarikçileri birbirinden ayıran sorular kozmetik değil, operasyonel niteliktedir: