Bir yapay zeka çözümü geliştiriyorsanız, ürününüzün pazara çıkış süresi büyük ölçüde eğitim amaçlı kaliteli veri kümelerinin zamanında kullanılabilirliğine bağlıdır. Yalnızca modellerinizin eğitim süreçlerini başlatmak, sonuçları optimize etmek ve çözümünüzü lansman için hazırlamak için gerekli veri kümeleriniz elinizde olduğunda.
Biliyorsunuz, kaliteli veri kümelerini zamanında elde etmek, her büyüklükteki ve ölçekteki işletme için zorlu bir görevdir. Bilmeyenler için, işletmelerin yaklaşık %19'u , yapay zeka çözümlerini benimsemelerini engelleyen en büyük faktörün veri eksikliği olduğunu belirtiyor.
Ayrıca, ilgili ve bağlamlı veriler üretmeyi başarsanız bile, veri etiketlemenin başlı başına bir zorluk olduğunu da anlamalıyız . Zaman alıcıdır ve mükemmel bir uzmanlık ve ayrıntılara dikkat gerektirir. Bir yapay zekanın geliştirme süresinin yaklaşık %80'i veri kümelerini etiketlemeye harcanır.
Artık, yapay zeka eğitiminin dayanak noktası oldukları için veri açıklama işlemlerini sistemlerimizden tamamen ortadan kaldıramayız. Elinizde açıklamalı veri yoksa, modelleriniz sonuçları (kaliteli sonuçlar bir yana) sağlayamaz. Şimdiye kadar, veri tabanlı zorluklar, açıklama teknikleri ve daha fazlası hakkında sayısız konuyu tartıştık. Bugün, veri etiketlemenin kendisi etrafında dönen bir başka önemli yönü tartışacağız.
Bu yazıda, spektrumda kullanılan iki tür açıklama yöntemini inceleyeceğiz:
- Manuel veri etiketleme
- Ve otomatik veri etiketleme
İki yöntem arasındaki farkları, manuel müdahalenin neden önemli olduğunu ve otomatik veri etiketlemenin risklerini açıklayacağız.
Manuel Veri Etiketleme
Adından da anlaşılacağı gibi, manuel veri etiketleme insanları içerir. Veri açıklama uzmanları, veri kümelerindeki öğeleri etiketlemenin sorumluluğunu üstlenir. Uzmanlar derken, tam olarak neye açıklama ekleyeceğini bilen KOBİ'leri ve alan yetkililerini kastediyoruz. Manüel süreç, ek açıklama için ham veri kümeleri ile sağlanan açıklayıcılarla başlar. Veri kümeleri, görüntüler, video dosyaları, ses kayıtları veya transkriptler, metinler veya bunların bir kombinasyonu olabilir.
Projelere, gerekli sonuçlara ve spesifikasyonlara dayalı olarak, açıklayıcılar, ilgili unsurların açıklanması üzerinde çalışır. Uzmanlar, belirli veri kümeleri ve amaçlar için hangi tekniğin en uygun olduğunu bilir. Projeleri için doğru tekniği kullanırlar ve zamanında eğitilebilir veri kümeleri sunarlar.
Manuel etiketleme sürecin yalnızca bir parçası olsa da, ek açıklama iş akışında kalite kontrolleri ve denetimler adı verilen ikinci bir aşama vardır. Bunda, açıklamalı veri kümeleri, özgünlük ve kesinlik açısından doğrulanır. Bunu yapmak için şirketler, oybirliğiyle sonuçlar için aynı veri kümelerinde birden fazla ek açıklamanın çalıştığı bir fikir birliği yöntemini benimser. Yorum ve işaretleme durumunda da tutarsızlıklar giderilir. Ek açıklama süreciyle karşılaştırıldığında, kalite kontrol aşaması daha az yorucu ve zaman alıcıdır.
Otomatik Veri Etiketleme
Artık veri etiketleme için ne kadar manuel çaba harcandığını anlıyorsunuz. Sağlık, hassasiyet ve detaylara gösterilen özen gibi sektörlerde kullanılacak çözümler daha da önemli hale geliyor. Daha hızlı veri etiketlemenin ve açıklamalı verilerin tesliminin önünü açmak için otomatik veri etiketleme modelleri giderek öne çıkıyor.
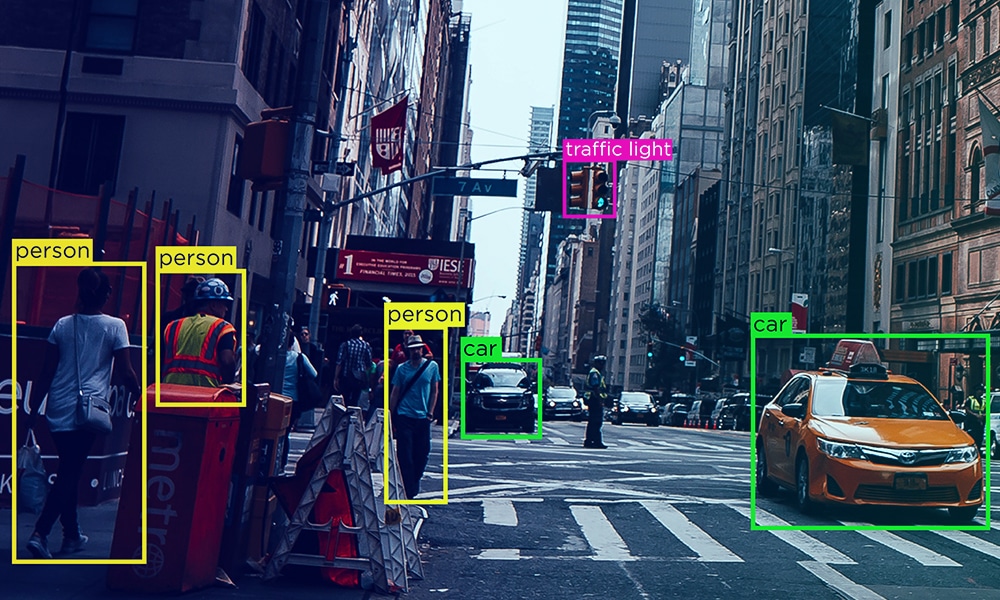
Bu yöntemde, yapay zeka sistemleri verileri açıklamayla ilgilenir. Bu, buluşsal yöntemler veya makine öğrenimi modelleri veya her ikisinin yardımıyla elde edilir. Sezgisel yöntemde, belirli bir etiketi doğrulamak için önceden tanımlanmış bir dizi kural veya koşuldan tek bir veri kümesi geçirilir. Koşullar insanlar tarafından belirlenir.
Bu verimli olsa da, veri yapıları sık sık değiştiğinde bu yöntem başarısız olur. Ayrıca, sistemleri bilinçli bir karar vermeye yönlendirmek için koşulların belirlenmesi karmaşık hale gelir. İnsanlar dondurma ve limonata arasında ayrım yapabilirken, beynin bu ayrımı nasıl bulduğunu bilmiyoruz. Bunu makinelerde çoğaltmak insanca imkansızdır.
Bu, AI sistemlerinden elde edilen sonuçların kalitesiyle ilgili bir takım endişelere yol açar. Otomasyonun devreye girmesine rağmen, veri etiketlerini doğrulamak ve düzeltmek için bir insana (veya bir grup insana) ihtiyacınız var. Ve bu, bir sonraki bölümümüz için mükemmel bir geçiş.
Yapay Zeka Destekli Açıklama: Zeka Beyin Gerektirir (Hibrit Yaklaşım)
En iyi sonuçlar için hibrit bir yaklaşım gereklidir. AI sistemleri daha hızlı etiketlemeyi halledebilirken, insanlar sonuçları doğrulayabilir ve optimize edebilir. Tüm veri açıklama sürecini makinelerin ellerine bırakmak kötü bir fikir olabilir ve bu nedenle insanları döngüye dahil etmek tamamen mantıklıdır.
Kurulmuş bir denge vardır ve süreç aynı zamanda uygun maliyetli yollarla da gerçekleşebilir. Uzmanlar, makinelerin daha iyi etiketler üretmesi için optimize edilmiş geri bildirim döngüleri bulabilir ve sonuçta ilgili manuel çabalara olan ihtiyacı azaltabilir. Makine güven puanlarındaki önemli artışla birlikte etiketlenen verilerin kalitesi de iyileştirilebilir.
Yukarı tamamlayan
Tamamen otonom veri etiketleme mekanizmaları asla işe yaramaz – en azından şimdilik. İhtiyacımız olan şey, zahmetli bir görevi yerine getirmede insan ve makineler arasında uyumdur. Bu aynı zamanda etiketlenmiş veri kümelerinin teslim süresini de artırır; böylece şirketler yapay zeka eğitim aşamalarını sorunsuz bir şekilde başlatabilirler. Ve yapay zeka modelleriniz için yüksek kaliteli veri kümeleri arıyorsanız, bugün bizimle iletişime geçin.