Bir bilgisayar görüşü modeli, ancak üzerinde eğitildiği görüntüler kadar keskin olabilir. Ona temiz, iyi etiketlenmiş bir veri seti verirseniz, tümörleri tespit etmeyi, fişleri okumayı veya otonom bir aracı şeridinde tutmayı öğrenir. Gürültü içeren bir veri seti verirseniz, kesinlikle yanlış sonuçlar verir. Bu nedenle, bilgisayar görüşü için doğru görüntü veri setleri, çoğu yeni başlayan ekip için model mimarisinden daha önemlidir ve bu nedenle ücretsiz, açık kaynaklı veri setleri, özel verilere yatırım yapmadan önce prototip oluşturmanın en hızlı yoludur.
Aşağıda, görevlere göre gruplandırılmış en kullanışlı 22 açık kaynaklı veri seti ve bunlardan birini nasıl seçeceğinize ve bu listenin ötesinde nereye bakacağınıza dair kısa bir kılavuz bulunmaktadır. Küresel bilgisayar görüşü pazarı 2025 yılında 20.75 milyar dolar değerindeydi ve 2026'da 24.14 milyar dolardan 2034'te 72.80 milyar dolara ulaşması bekleniyor ( Fortune Business Insights, 2025 ), bu nedenle kaliteli eğitim görüntülerine olan talep giderek artıyor.
Önemli Noktalar
- Açık kaynaklı görüntü veri kümeleri Özel verileri devreye almadan önce bilgisayar görüşü modellerinin prototiplerini ücretsiz olarak oluşturmanıza olanak tanır.
- Veri setini göreve uygun hale getirin: sınıflandırma, tespit veya segmentasyon, her biri farklı etiketler gerektirir.
- ImageNet, COCO ve Open Images gibi kıyaslama setleri sektör standartları olmaya devam ediyor.
- Ücretsiz veri kümeleri nadiren tam olarak kullanım amacınıza uyar; bu nedenle özel bir veri oluşturma adımı planlayın.
Bilgisayarla görme için görüntü veri kümeleri nelerdir?
Bilgisayar görüşü için görüntü veri kümeleri, görsel bilgileri yorumlayan modelleri eğitmek ve doğrulamak için kullanılan etiketlenmiş görüntülerin düzenlenmiş koleksiyonlarıdır. Her görüntü, bir algoritmaya neye baktığını öğreten ek açıklamalar (sınıf etiketi, sınırlayıcı kutular veya piksel düzeyinde maskeler) taşır. Ek açıklama , ham pikselleri denetimli eğitim sinyallerine dönüştüren etiketleme katmanıdır. Bu olmadan, bir modelin görüntüleri olur ancak öğreneceği bir ders olmaz.
Görüntü Veri Seti Görevleri: Sınıflandırma, Segmentasyon, Algılama ve Daha Fazlası
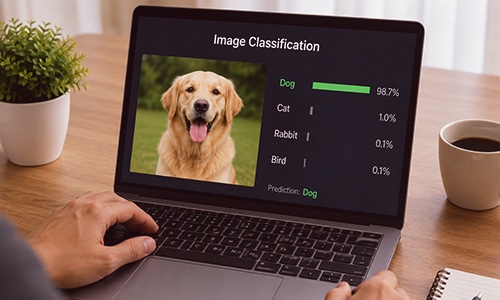
Görüntü sınıflandırması, bilgisayarla görmenin en temel görevlerinden biridir. Bu süreçte, bir model, içeriğine dayanarak tüm bir görüntüye etiket atamayı öğrenir. Örneğin, bir görüntü sınıflandırma veri seti, bir modelin kedi ve köpek görüntülerini ayırt etmesine veya farklı bitki türlerini tanımlamasına yardımcı olabilir. Bu görev, otomatik fotoğraf etiketleme, tıbbi görüntülerden hastalık teşhisi ve sahne kategorizasyon kıyaslamaları gibi uygulamalar için çok önemlidir.
Nesne tespiti, yalnızca bir görüntü içindeki nesnelerin varlığını belirlemekle kalmayıp, sınırlayıcı kutular kullanarak konumlarını da belirleyerek işleri bir adım daha ileri götürür. Sınırlayıcı kutularla etiketlenmiş görüntüler içeren nesne tespiti veri kümeleri, otonom araçlarda yaya tespiti, güvenlik gözetimi ve perakende analitiği gibi uygulamalar için hayati öneme sahiptir. Nesne tespiti ayrıca, gerçek dünya senaryoları için sağlam bilgisayar görüşü algoritmaları geliştirmenin de önemli bir bileşenidir.
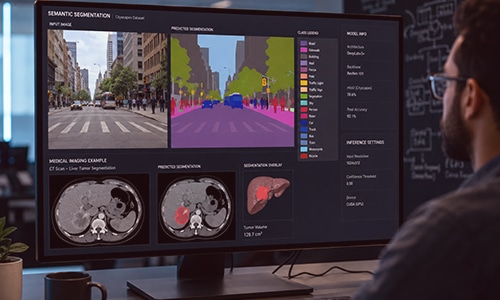
Semantik segmentasyon, bir görüntüdeki her pikseli belirli bir kategoriye sınıflandırmayı içerir ve sahne hakkında ayrıntılı bir anlayış sağlar. Bu piksel düzeyindeki trimap segmentasyonu, organların veya tümörlerin hassas bir şekilde sınırlandırılmasının gerekli olduğu tıbbi görüntüleme gibi görevlerde ve yollar, kaldırımlar ve araçlar arasında ayrım yapmanın kritik olduğu otonom sürüş için kentsel ortamlarda özellikle önemlidir.
En iyi genel amaçlı görüntü veri kümeleri hangileridir?
Genel veri kümeleri, modelleri kıyaslamak ve daha dar bir görev üzerinde ince ayar yapmadan önce ağları önceden eğitmek için kullanılan büyük, geniş etiketli koleksiyonlardır.
- IMAGEnet — WordNet hiyerarşisine göre düzenlenmiş, 1,000 kategoriye yayılmış 1.2 milyon görsel. Modern derin öğrenmenin başlangıcını sağlayan ölçüt.
- Google Açık Görseller Sürüm 7 — 600 nesne sınıfında yaklaşık 9 milyon görüntü, etiketler, kutular, bölümlendirme ve ilişkilerle birlikte açıklanmıştır.
- Cifar-10 — 10 sınıfta 60,000 adet küçük 32x32 renkli resim. Hızlı deneyler için standart bir başlangıç seti.
- Oxford-IIIT Evcil Hayvan Veri Seti — 37 evcil hayvan ırkı, ırk etiketleri, kafa kutuları ve piksel düzeyinde trimap segmentasyonu ile birlikte.
- SA-1B (Herhangi Bir Şeyi Segmente Edin) — 11 milyondan fazla görüntü ve 1.1 milyar maske ile mevcut en büyük segmentasyon veri seti.
- ADE20K — 25,000'den fazla yoğun şekilde etiketlenmiş sahne görüntüsü, anlamsal segmentasyon için önemli bir ölçüt.
- CelebA — Her birinde 40 özellik açıklaması bulunan 200,000'den fazla ünlü fotoğrafı.
- YouTube-8M — Video anlama için makine tarafından oluşturulmuş görsel varlık etiketlerine sahip milyonlarca video kimliği.
Doğru bilgisayar görüşü veri setini nasıl seçersiniz?
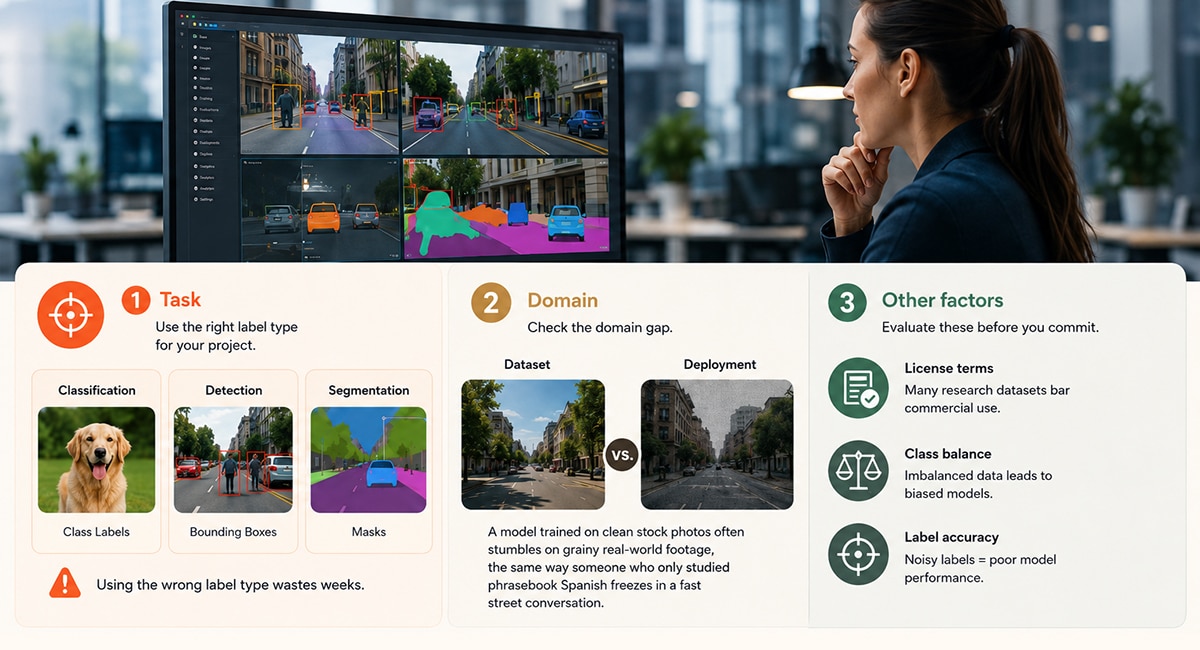
Veri setini seçerken üç şeye dikkat edin: görev, etiket türü ve etki alanı. Bir sınıflandırma projesi sınıf etiketlerine ihtiyaç duyar; bir tespit projesi sınırlayıcı kutulara ihtiyaç duyar; bir segmentasyon projesi maskelere ihtiyaç duyar — yanlış etiket türü kullanmak haftalarca zaman kaybına neden olur. Ardından, etki alanı farkını kontrol edin. Temiz stok fotoğraflar üzerinde eğitilmiş bir model, tıpkı sadece İspanyolca konuşma kılavuzu öğrenmiş birinin hızlı bir sokak konuşmasında donup kalması gibi, grenli gerçek dünya görüntülerinde genellikle takılır. Veri setinin görüntüleri, uygulama koşullarınıza (aydınlatma, açı, çözünürlük, demografik bilgiler) ne kadar yakınsa, o kadar az yeniden eğitime ihtiyacınız olacaktır.
Ayrıca lisans koşullarını (birçok araştırma veri seti ticari kullanımı yasaklıyor), sınıf dengesini ve etiket doğruluğunu da göz önünde bulundurun. Shaip ekibi, yüzlerce bilgisayar görüşü projesinde, kamuya açık veri setlerinin sizi çalışan bir prototipe ulaştırdığını ancak nadiren bunun ötesine taşıdığını sürekli olarak tespit ediyor; üretim doğruluğu neredeyse her zaman belirli kameralarınızı, ortamlarınızı ve uç durumlarınızı yansıtan verilere ihtiyaç duyuyor.
Özel bir veri seti ne zaman oluşturmalısınız?
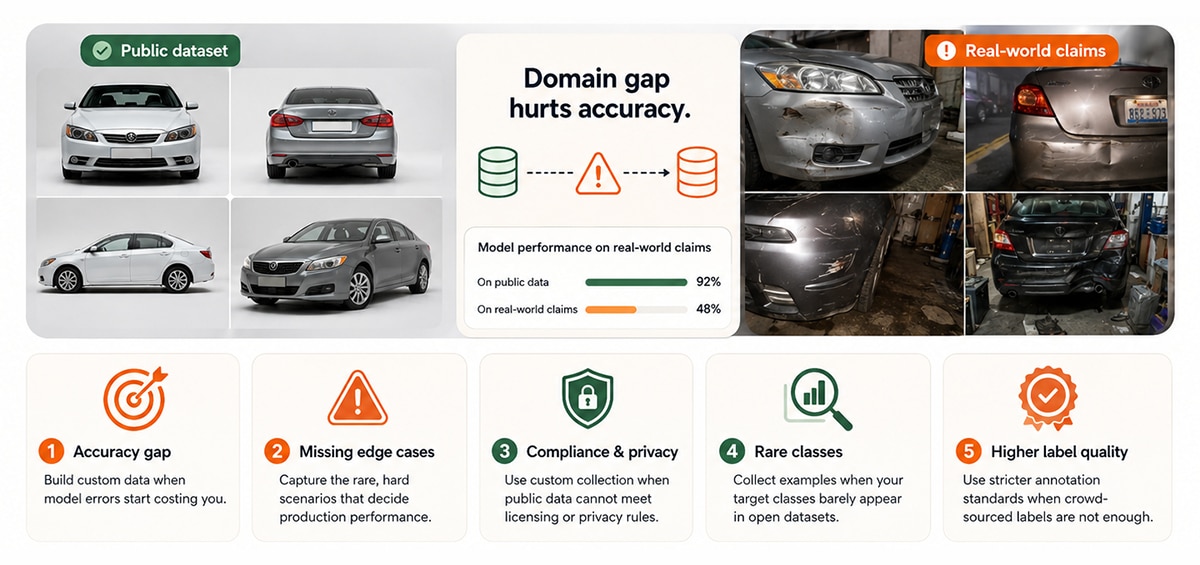
Doğruluk, kapsam veya uyumluluk açıkları size maliyet getirmeye başladığında özel veri oluşturun. Orta ölçekli bir sigorta şirketinin araç hasar tahminlerini otomatikleştirmeye çalıştığını düşünün: kamuya açık araç veri setleri temiz stüdyo çekimleri gösterirken, gerçek hasar talepleri ezik tamponların loş, karmaşık telefon fotoğrafları şeklinde gelir. Hiçbir açık veri seti bunu karşılamaz, bu nedenle model temsili görüntüler üzerinde eğitilene kadar düşük performans gösterir. İşte bu, dönüm noktasıdır.
Herkese açık veri kümeleri uç durumlarınızı kapsamadığında, özel veri toplama ve açıklama kaynakları, modelin demo veya üretim için hazır olup olmadığını belirleyen nadir ve zor senaryolar da dahil olmak üzere, tam koşullarınızı yansıtan görselleri etiketler ve etiketler. Özel veriler ayrıca, lisanslama veya gizlilik kuralları herkese açık veri kümelerini dışladığında, sınıflarınız açık veri kümelerinde nadiren göründüğünde veya etiket kalitesinin, kitle kaynaklı açıklamaların garanti edebileceğinden daha yüksek bir standardı karşılaması gerektiğinde de önemlidir. Projeniz ücretsiz veri kümelerinin sunabileceğinden daha büyük hale geldiyse, bir sonraki adım, kullanım durumunuza özgü toplama hacimlerini, açıklama özelliklerini ve uyumluluk gereksinimlerini belirlemektir.
Shaip, özel bilgisayar görüşü veri kümeleri konusunda nasıl yardımcı olabilir?
Shaip, modelinize, ortamınıza ve uç durumlarınıza tam olarak uyacak şekilde tasarlanmış özel görüntü veri kümeleri oluşturur; bu da herhangi bir ücretsiz veri kümesinin sunabileceğinin ötesine geçer. Açık veriler genel nitelikteyken, çalışmamız sizin probleminizden yola çıkar: kullandığınız kameralar, karşılaştığınız aydınlatma ve açılar, üretimde doğruluğu bozan nadir senaryolar. İşte bu, yönetilen, uçtan uca bir hizmete nasıl dönüşüyor: