Barkod Tarama Video Veri Kümesi
Birden fazla coğrafyadan 5-30 saniye süreli 40k barkod videoları
Kullanım Örneği: Nesne Tanıma Modeli
Format: Videolar
Hacim: 5,000+
Açıklama: Yok

Özel veri toplama, uzman etiketleme ve %99 doğrulukla etiketlenmiş hazır OCR veri kümeleri (faturalar, makbuzlar, el yazısı, tablolar ve çok dilli belgeler) sayesinde modelleriniz herhangi bir belgeyi, herhangi bir dilde okuyabilir.
OCR eğitim verileri , doğru metin transkripsiyonları ve sınırlayıcı kutu açıklamalarıyla eşleştirilmiş, etiketlenmiş bir belge görüntüsü kümesidir; bu görüntüler taramalar, fotoğraflar ve basılı veya el yazısı metinlerin PDF'leridir. Makine öğrenimi modelleri, belgeleri düzenlenebilir, makine tarafından okunabilir metne dönüştürmek için bu görüntüden metne verilerinden öğrenir.
İster belge anlama modelinizi ince ayar yapıyor olun ister sıfırdan optik karakter tanıma (OCR) sistemi kuruyor olun, etiketlenmiş veri kümelerinizin kalitesi doğruluk sınırınızı belirler. Shaip, alanında uzman etiketleyicileri kanıtlanmış bir Six Sigma kalite güvence süreci ve güvenli, uyumlu bir platformla birleştirerek, modellerinizin güvenebileceği fatura, makbuz, el yazısı ve çok dilli OCR verilerini, şirket içinde geliştirmenin maliyetinin çok daha düşük bir kısmıyla sunar.
Faturalar, makbuzlar, kimlikler, el yazısı ve çok dilli taramalar da dahil olmak üzere, belge görüntülerini tam olarak sizin belirttiğiniz özelliklere göre, gerçek dünya koşullarında ve istisnai durumlarda, 60'tan fazla ülkede yasalara uygun olarak temin ediyor ve topluyoruz.
Alanında uzman kişiler tarafından karakter, kelime ve satır düzeyinde metin transkripsiyonu, ayrıca sınırlayıcı kutu, dörtgen ve çokgen etiketleme işlemleri, çok aşamalı Six Sigma kalite güvencesiyle birlikte gerçekleştirilir.
Prototip oluşturmak ve kıyaslama yapmak için bugün hazır, kalite kontrolünden geçmiş OCR veri kümelerini (el yazısı tanıma, fiş ve fatura, tablo ve çok dilli belge verileri) lisanslayın.
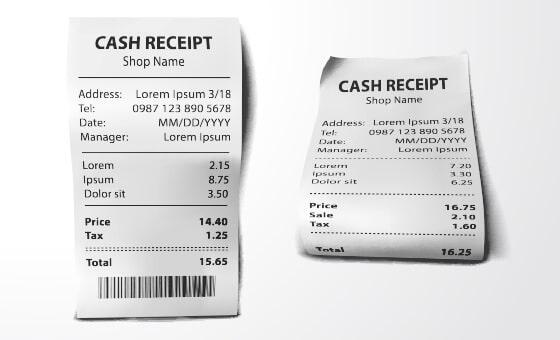

Fatura ve makbuz OCR için kalem öğeleri, toplamlar, vergi ve tedarikçi alanları etiketlenmiştir; bu da hesap ödemeleri ve gider otomasyonunu güçlendirir.


ICR ve el yazısı tanıma modelleri için birçok yazar, stil ve dilden oluşan serbest el yazısı metin veri kümeleri.

Karmaşık tablolardan ve yapılandırılmış tablo belgelerinden satır, sütun ve hücre düzeyinde veri çıkarma.

Kimlik doğrulama ve KYC (Müşterinizi Tanıyın) işlemleri için anahtar-değer açıklaması içeren pasaportlar, ehliyetler ve kimlik kartları.

Alan düzeyinde etiketleme ve anahtar-değer çıkarımı içeren uçak biletleri, başvurular ve yapılandırılmış formlar.
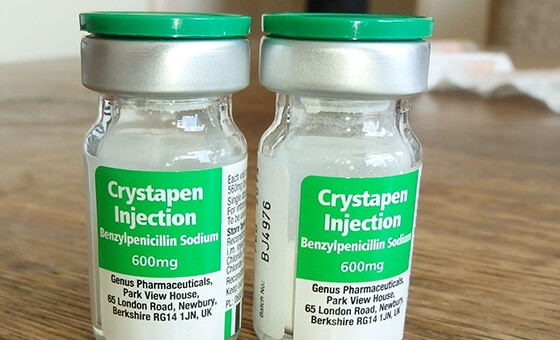
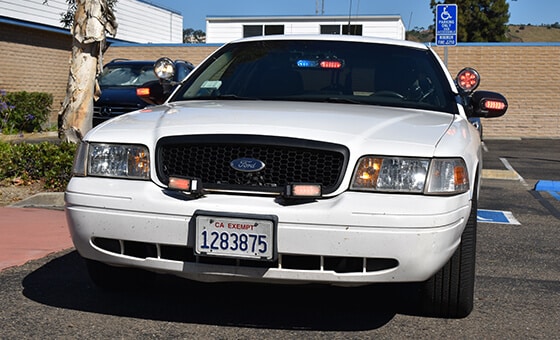
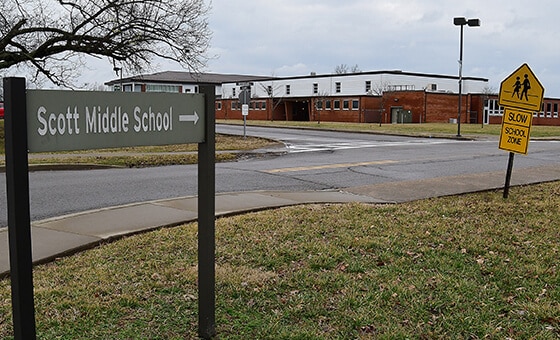
Doğal, gerçek dünya görüntü koşullarında yakalanmış tabela, etiket ve ürün metinleri.
Hazır katalog
Önceden oluşturulmuş, kalite kontrolünden geçmiş OCR veri kümelerini bugün lisanslayabilir veya özel bir OCR veri kümesi oluşturmak için başlangıç noktası olarak kullanabilirsiniz. Bu veri kümeleri el yazısı, fiş ve fatura, tablo, çok dilli ve sahne metni verileridir.
Birden fazla coğrafyadan 5-30 saniye süreli 40k barkod videoları
Kullanım Örneği: Nesne Tanıma Modeli
Format: Videolar
Hacim: 5,000+
Açıklama: Yok
İngilizce, Fransızca, İspanyolca, İtalyanca ve Felemenkçe gibi 15.9 dilde 5 bin makbuz, fatura, satın alma siparişi görüntüsü

Kullanım Örneği: Belge Tanıma Modeli
Biçim: Görüntüler
Hacim: 15,900+
Açıklama: Yok
Alman ve Birleşik Krallık Faturalarının 45 bin görüntüsünü teslim etti

Kullanım Örneği: Fatura Tanıma Modeli
Biçim: Görüntüler
Hacim: 45,000+
Açıklama: Yok
Araç Plakalarının farklı açılardan 3.5k görüntüsü

Kullanım Senaryosu: Hayır. Plaka Tanıma
Biçim: Görüntüler
Hacim: 3,500+
Açıklama: Yok
İngilizce, Fransızca, İspanyolca, Almanca, İtalyanca, Portekizce ve Korece dillerinde toplanan ve açıklamalı 90 belge

Kullanım Örneği: OCR Modeli
Biçim: Görüntüler
Hacim: 90,000+
Açıklama: Evet
Tabelalar, Vitrinler, Şişeler, Belgeler, Posterler, El ilanlarından Japonca, Rusça ve Korece dillerinde 23.5 bin belge.

Kullanım Örneği: Çok Dilli OCR Modeli
Biçim: Görüntüler
Hacim: 23,500+
Açıklama: Evet
Büyük Avrupa şehirlerinden alınan 11.5k+ alındı görüntüsü

Kullanım Örneği: Nesne algılama modeli
Biçim: Görüntüler
Hacim: 11,500+
Açıklama: Yok
Birden çok dilde 75k+ makbuz
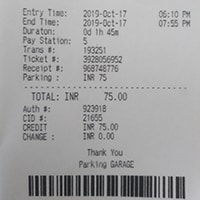
Kullanım Örneği: Fiş Yapay Zeka Modelleri
Biçim: Görüntüler
Hacim: 75,000+
Açıklama: Yok
Sektöre Göre
Reçete, laboratuvar raporu ve tıbbi form veri kümeleri — Klinik doküman yapay zekası için HIPAA uyumlu işleme.
Finansal belge verilerinin çıkarılması için fatura, banka ekstresi, çek ve KYC belgesi verileri.
Sevkiyat ve kargo otomasyonu için sevk irsaliyeleri, teslimat fişleri ve konşimentolar.
Hasar bildirim formları, poliçe belgeleri ve el yazısıyla yazılmış başvurular ölçekli olarak etiketlenmiştir.
Gider, sadakat ve ürün yönetimi yapay zekası için fiş, fiyat etiketi ve raf etiketi verileri.
Belge işleme programları için sözleşme, kayıt ve arşiv tarama dijitalleştirme veri kümeleri.
Sürecimiz
OCR doğruluğu nasıl sağlanıyor? Doğru etiketleme türleri ve çok aşamalı insan kalite kontrolü sayesinde. Sınır kutusu, dörtgen ve çokgen etiketleme kullanarak karakter, kelime ve satır düzeyinde etiketleme yapıyoruz, ardından teslimattan önce her partiyi doğruluyoruz - %99 doğruluk hedefliyoruz.*
Belge türlerini, dilleri ve istisnai durumları tanımlayın; uyumlu belge görsellerini temin edin veya toplayın.
Eğitimli uzmanlar tarafından karakter/kelime/satır metin transkripsiyonu + sınırlayıcı kutu, dörtgen ve çokgen etiketleme.
Bağımsız inceleme ve Six Sigma kontrolleri, Karakter ve Kelime Hata Oranını SLA'nıza göre ölçer.
Modellemeye hazır formatta gönderin; geri bildirimler doğrultusunda iyileştirmeler yapın ve zaman içinde veri kümesi kapsamını genişletin.

Shaip, kavisli tabelalar, solmuş fişler, el yazısı ve karışık yazı tipleri de dahil olmak üzere 10'dan fazla metin kaynağında kelime düzeyinde sınırlayıcı kutular ve karakter düzeyinde transkripsiyon içeren uçtan uca bir OCR açıklama hattı oluşturdu. Beş özellik katmanı ve çift QA, %99 doğrulukla üretime hazır veri kümeleri sağladı.
Shaip'i Neden Seçmelisiniz?
Shaip, yıllarını her türlü yöntemden yapay zeka eğitim verilerini kaynak bulma, toplama ve etiketleme ile geçirdi. Optik karakter tanıma (OCR) için bu, bir gecede oluşturulamayacak bir derinlik anlamına gelir: küresel erişim, alan uzmanlığı, kurumsal düzeyde güvenlik ve her OCR veri setinin arkasında tescilli araçlar.
60'tan fazla ülkeden , 65'ten fazla dilde ve 70'ten fazla konuda derlenmiş ve sunulmuş veriler ; çoğu satıcının sunamadığı bir kapsam.
30,000'den fazla eğitimli veri etiketleyici ve sektör uzmanı, genel etiketleme yerine hassas, bağlam odaklı OCR veri etiketlemesi sunmaktadır.
GDPR, HIPAA, CCPA, ISO 9001:2015, ISO 27001 ve SOC 2 Tip II standartlarına uygunluk — gizlilik sözleşmeleri ve uçtan uca güvenli veri işleme ile.
Shaip Manage , Shaip Work ve Shaip Intelligence, proje denetimi, küresel iş gücü koordinasyonu ve otomatik veri doğrulama işlemlerini yürütür.
Verilerinizi kendiniz oluşturmanın maliyetinin çok daha düşük bir kısmıyla kaliteli verilere ulaşın ve modellerinizi daha hızlı bir şekilde pazara sunun.
Six Sigma kalite güvencesi ve ölçülebilir doğruluk hedefleri (Karakter ve Kelime Hata Oranı), üretimde güvenebileceğiniz veriler anlamına gelir.

OCR, makinelerin basılı metin ve görüntüleri okumasını sağlayan bir teknolojidir. Genellikle belgelerin saklanması veya işlenmesi için dijitalleştirilmesi gibi iş uygulamalarında ve harcama geri ödemesi için bir makbuzun taranması gibi tüketici uygulamalarında kullanılır.

Sağlık sektörü, AI'da yeni ve gelişmiş teknolojilerin başlamasıyla birlikte iş akışlarında bir paradigma değişikliği ile karşı karşıyadır. AI araçlarından ve teknolojilerinden yararlanarak, daha yüksek sağlık hizmeti verimliliği ile iyileştirilmiş tıbbi sonuçlar elde edilebilir.

Hiç Google veya Alexa'nın sizi nasıl "anladığını" görünce şaşırıp kafanızı kaşıdınız mı? Yoksa kendinizi kulağa ürkütücü bir şekilde insan gibi gelen, bilgisayar tarafından oluşturulmuş bir makale okurken mi buldunuz? Yalnız değilsin. Perdeyi geri çekmenin ve sırrı ortaya çıkarmanın zamanı geldi: Büyük Dil Modelleri veya LLM'ler.


Veri toplamadan, etiketlemeye, lisanslamaya ve doğrulamaya kadar; güvenebileceğiniz verilerle pazara daha hızlı ulaşmanıza yardımcı olacağız.
İletişimOCR (Optik Karakter Tanıma), basılı veya elle yazılmış metinleri, görüntü veya taranmış belgelerde makine tarafından okunabilir metne dönüştüren bir teknolojidir. Etiketli veri kümeleriyle yapay zeka modellerini eğiterek fiş, fatura ve form gibi çeşitli formatlardaki desenleri ve karakterleri tanımalarını sağlar.
OCR, belge işleme, veri çıkarma ve dijitalleştirme gibi görevlerin otomatikleştirilmesi için hayati önem taşır. İşletmelerin zamandan tasarruf etmesine, hataları azaltmasına ve büyük hacimli fiziksel veya taranmış belgeleri işlemede verimliliği artırmasına yardımcı olur.
Makine öğrenimi, modelleri çeşitli veri kümeleriyle eğiterek OCR'yi geliştirir ve yazı tipleri, el yazısı stilleri, düzenler ve dillerdeki farklılıkları ele almalarını sağlar. Zamanla modeller genelleme yapmayı ve tanıma oranlarını iyileştirmeyi öğrenir.
OCR, makbuzlar, faturalar, el yazısı formlar, pasaportlar, tıbbi etiketler, biletler ve hatta taranmış PDF'ler veya resimlerdeki karmaşık tablolar gibi çok çeşitli belgeleri işleyebilir.
Tablo OCR, taranmış belgelerdeki, PDF'lerdeki veya resimlerdeki tablolardan yapılandırılmış verileri çıkarır. Satır ve sütunları Excel gibi makine tarafından okunabilir biçimlere dönüştürerek veri işlemeyi daha hızlı ve daha doğru hale getirir.
OCR, sağlık, finans ve e-ticaret gibi sektörlerde yaygın olarak kullanılmaktadır. Tıbbi kayıtlardan, faturalardan, makbuzlardan ve diğer belgelerden veri çıkarmayı otomatikleştirerek sektörler genelinde operasyonel verimliliği artırır.
Çok dilli OCR modelleri, çeşitli dilleri, lehçeleri ve yazı tiplerini kapsayan veri kümeleriyle eğitilir. Bu sayede, farklı yazı tipleri ve tipografilerdeki metinleri doğru bir şekilde tanıyıp işleyebilirler.
OCR modellerinin eğitimi, çeşitli el yazılarını, yazı tiplerini, düzenleri ve dilleri kullanmayı içerir. Tıbbi makbuzlar veya çok dilli içerikler gibi karmaşık belgelerin tanınmasında doğruluk sağlamak da önemli bir zorluktur.
Shaip, makbuzlar, faturalar, el yazısı formlar ve çok dilli belgeler dahil olmak üzere yüksek kaliteli, müşteriye özel OCR veri kümeleri sunar. Bu veri kümeleri, maksimum doğruluk ve güvenilirlik sağlamak için düzenlenir, açıklama eklenir ve doğrulanır.
Shaip'in OCR eğitim çözümleri son derece ölçeklenebilirdir ve olağanüstü doğruluk sağlamak üzere tasarlanmıştır. Süreçleri, gelişmiş yapay zeka araçlarını insan uzmanlığıyla birleştirerek büyük veri kümelerinde bile güvenilir sonuçlar sağlar.
Maliyet, ihtiyaç duyulan veri setinin türüne, hacmine ve karmaşıklığına bağlıdır. Özelleştirilmiş fiyatlandırma için işletmeler, özel ihtiyaçlarını görüşmek üzere doğrudan Shaip ile iletişime geçebilirler.

Sitemizdeki deneyiminizi iyileştirmek için çerezler kullanıyoruz. Sitemizi kullanarak çerezlere onay vermiş olursunuz.
Aşağıdan çerez tercihlerinizi yönetin:
Temel çerezler temel işlevleri etkinleştirir ve web sitesinin düzgün çalışması için gereklidir.
Google Etiket Yöneticisi, kod değişikliğine gerek kalmadan web sitenizdeki pazarlama etiketlerinin yönetimini kolaylaştırır.
İstatistik çerezleri bilgileri anonim olarak toplar. Bu bilgiler ziyaretçilerin web sitemizi nasıl kullandığını anlamamıza yardımcı olur.
Google Analytics, bilinçli pazarlama kararları almak için web sitesi trafiğini izleyen ve analiz eden güçlü bir araçtır.
Hizmet URL'si: policies.google.com (yeni bir pencerede açılır)
Pazarlama çerezleri, web sitelerine gelen ziyaretçileri takip etmek için kullanılır. Amaç, bireysel kullanıcıya alakalı ve ilgi çekici reklamlar göstermektir.
Google Ads, işletmelerin Google arama sonuçlarında ve iş ortağı sitelerinde gösterilen hedefli reklamlar oluşturmasını sağlayan çevrimiçi bir reklam platformudur.
Hizmet URL'si: policies.google.com (yeni bir pencerede açılır)
HubSpot, işletme büyümesini kolaylaştıran hepsi bir arada bir pazarlama, satış ve müşteri hizmetleri platformudur.
Hizmet URL'si: legal.hubspot.com (yeni bir pencerede açılır)
Çerez Politikamız ve Gizlilik Politikamızda daha fazla bilgi bulabilirsiniz.